

Grandream
Google「Gemini 3.8 Live / Extended Thinking」発表|OpenAI Realtime API(gpt-realtime-2.1)と料金・遅延・日本語応答を同一音声で実測比較
Googleが2026年9月15日、音声対話向けの新モデル Gemini 3.8 Live と Gemini 3.8 Live Extended Thinking を公開しました(Googleの発表)。Gemini API・Google AI Studioで即日利用でき、Search Liveや Gemini アプリの音声会話にも順次入ります。
発表の要点は次の4つです。
- 3.8 Live は「規模とコスト効率」向け。97言語を会話の途中で自動判別して切り替え、ツール呼び出しやAPI実行を会話を止めずに裏で回す
- 3.8 Live Extended Thinking は「考えながら話す」上位モデル。「確認しますね」と先に声を返しつつ裏で多段推論し、進捗を口頭で伝える
- 独立評価 Artificial Analysis の Speech to Speech Quality Index で Extended Thinking が 82.6 を記録し、OpenAI の GPT-Live-1(GPT-6 Astra 構成)81.5、xAI の Grok Voice Think Fast 2.0 の 81.3 を上回って首位
- 料金は音声入力 $3 / 100万トークン、音声出力 $12 / 100万トークン で、OpenAI Realtime API($32 / $64)の 10分の1
この記事では、公式料金を「1分いくら」に換算して並べたあと、OpenAI Realtime API の現行モデル gpt-realtime-2.1 / 2.1-mini と、Gemini 3.8 Live / Extended Thinking(思考レベル low・high)の5構成に、同じ日本語の質問音声を投げて、1往復の実額・声が返るまでの時間・応答の中身を比較します。用途は当社が手がける歯科医院の電話受付AIを想定しました。
1. 公式料金:どちらも「音声トークン課金」だが単価は10倍違う
両社とも音声を「トークン」に換算して課金します。ただし1秒あたりのトークン数と単価がどちらも違うので、定価表をそのまま並べても比較になりません。まず定価、次に1分換算です。
定価(100万トークンあたり・USD)
モデル | テキスト入力 | 音声入力 | テキスト出力 | 音声出力 | 位置づけ |
|---|---|---|---|---|---|
gemini-3.8-live | $0.75 | $3.00 | $4.50 | $12.00 | 新・既定 |
gemini-3.8-live-extended-thinking | $0.75 | $3.00 | $4.50(思考トークン込み) | $12.00 | 新・高推論 |
gpt-realtime-2.1 | $4.00(キャッシュ $0.40) | $32.00(キャッシュ $0.40) | $24.00 | $64.00 | OpenAI 現行推奨 |
gpt-realtime-2.1-mini | $0.60(キャッシュ $0.06) | $10.00(キャッシュ $0.30) | $2.40 | $20.00 | OpenAI 廉価 |
gpt-live-1(参考) | — | $0.05/分(秒課金) | — | — | 全二重の音声層のみ。推論は別モデルで別課金 |
Gemini の2モデルは同一料金で、Extended Thinking の思考トークンはテキスト出力単価($4.50)に含まれます。OpenAI は入力にプロンプトキャッシュが効き、同じ指示文(システムプロンプト)を繰り返し送る音声エージェントではキャッシュ分が $0.40 に落ちます。Gemini の Live API にはキャッシュ割引の記載がありません。
1分あたりに換算すると
音声トークンの換算レートは、Google が公式に「音声入力 $0.005/分・音声出力 $0.018/分」と併記しています(1秒 ≒ 25トークン)。OpenAI は「入力 1トークン = 100ms、出力 1トークン = 50ms」なので、1分の発話は入力600トークン・出力1,200トークンです。
モデル | ユーザー音声 1分 | AI 音声 1分 |
|---|---|---|
gemini-3.8-live / extended-thinking | $0.005 | $0.018 |
gpt-realtime-2.1 | $0.019 | $0.077 |
gpt-realtime-2.1-mini | $0.006 | $0.024 |
gpt-live-1(音声層のみ) | $0.05(無音・処理待ち込み) | 同左に含む |
Gemini 3.8 Live は gpt-realtime-2.1 の約4分の1、mini とほぼ同額の単価です。ただし通話の総額は音声だけで決まりません。OpenAI Realtime は応答のたびに会話履歴全体を入力として再送し、Gemini Extended Thinking は思考トークンと隠れたプロンプトが乗ります。そこが定価表では見えないので、実測しました。
2. 比較方法
「傾向をつかむ」目的の軽量計測です。
- 対象5構成:
gpt-realtime-2.1/gpt-realtime-2.1-mini/gemini-3.8-live/gemini-3.8-live-extended-thinking(思考レベルlow)/同(high) - 入力音声は5シナリオ、すべて同一ファイル。macOS の日本語音声合成(Kyoko)で作成し、Gemini には 16kHz、OpenAI には 24kHz の PCM を渡した(両 API の仕様上の入力形式)
- システムプロンプトは共通。歯科医院の受付AIとして診療時間・駐車場・英語対応医師・初診料を与え、「2〜3文で簡潔に」「英数字は一字ずつ」「予約は
book_appointmentツールを呼ぶ」と指示 - ターン検出は両方サーバー側 VAD(後述の理由)。発話のあとに 1.5 秒の無音を送り、AI が話し始めるのを待つ
- 送信速度は2通り。音声ファイルを一括で送る「一括」(3回反復・75セッション)と、マイク入力と同じ100msごとに送る「実時間」(2回反復・50セッション)。合計125セッション、すべて逐次実行
- 料金は API が返す消費トークン(
usage)に上記の公式単価を掛けて算出 - 遅延は「ユーザー発話の最後の音声を送った時刻」から「AI の最初の音声が届いた時刻」まで(TTFA:Time to First Audio)。VAD の終端判定を含む、利用者が体感する待ち時間
- 品質は API が返す応答音声の書き起こしと、ツール呼び出しの引数を目視で採点
シナリオ | 質問(音声) | 見るもの |
|---|---|---|
S1 基本応答 | 今日の診療時間を教えてください | 指示文の事実を正しく返すか、最短の往復 |
S2 英数字の復唱 | 予約番号 A7392B と電話番号 090-1234-5678 を復唱して | 英数字を一字ずつ正確に聞き取り・読み上げできるか |
S3 計算と複合質問 | 大人2人と子ども1人(子どもは半額)の初診料合計は?土曜午後は診療している? | 算術と2問同時回答 |
S4 予約ツール呼び出し | 明日の午後3時に山田で予約、電話番号 080-1111-2222 | 発話から引数を抽出してツールを呼び、結果を口頭で返せるか |
S5 言語切替 | Hello, do you have an English speaking dentist? あと、駐車場はありますか | 英語と日本語が混ざった質問に、それぞれの言語で答えるか |
3. 結果①:1往復の実額は Gemini 3.8 Live が gpt-realtime-2.1 の4分の1、mini とほぼ同額
モデルごとに、1往復あたりの実額の中央値(一括送信・各15セッション)と、25往復の合計(一括75 + 実時間50 = 125セッション)を並べます。1往復 = ユーザーの質問1回とAIの応答1回で、S4はツール呼び出しの往復を含みます。
モデル | 1往復の実額(中央値) | 25往復の合計 | gpt-realtime-2.1 比 | 応答音声の長さ(中央値) |
|---|---|---|---|---|
gpt-realtime-2.1 | $0.0214 | $0.613 | 1.00 | 11.3秒 |
gpt-realtime-2.1-mini | $0.0070 | $0.171 | 0.28 | 13.9秒 |
gemini-3.8-live | $0.0052 | $0.151 | 0.25 | 9.2秒 |
gemini-3.8-live-extended-thinking(low) | $0.0072 | $0.241 | 0.39 | 9.6秒 |
gemini-3.8-live-extended-thinking(high) | $0.0071 | $0.247 | 0.40 | 8.9秒 |
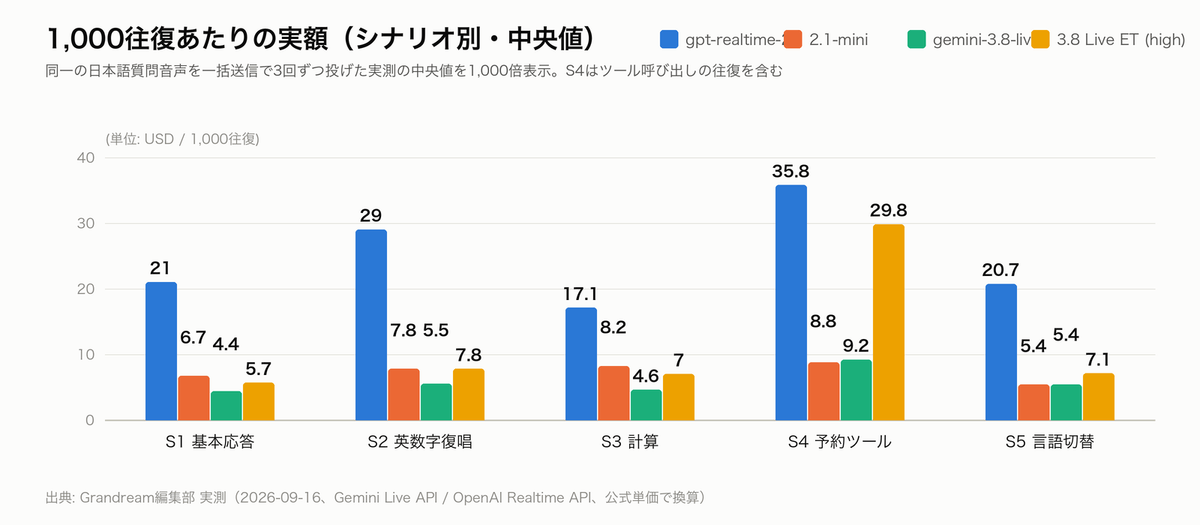
定価の単価差(10倍)ほどは開きません。理由は2つあります。
- OpenAI はプロンプトキャッシュが効く。同じシステムプロンプトを毎セッション送るため、gpt-realtime-2.1 は平均で入力の2〜4割がキャッシュ単価($0.40)で処理されました
- OpenAI の応答は長い。同じ質問に対して gpt-realtime-2.1 は平均11秒、mini は14秒話し、Gemini は9秒前後でした。音声出力は最も高い単価なので、話す長さがそのまま額に響きます
それでも Gemini 3.8 Live は gpt-realtime-2.1 の4分の1、mini と同水準です。Extended Thinking は 3.8 Live より4割ほど高くなりました。原因はトークン内訳を見ると分かります。
Extended Thinking は「隠れた入力」が毎ターン3,000〜4,000トークン乗る
モデル | テキスト入力 | 音声入力 | 音声出力 | 思考トークン |
|---|---|---|---|---|
gpt-realtime-2.1 | 832 | 111 | 245 | 49(reasoning) |
gpt-realtime-2.1-mini | 832 | 111 | 268 | 104(reasoning) |
gemini-3.8-live | 840 | 482 | 260 | 181 |
gemini-3.8-live-extended-thinking(low) | 4,585 | 499 | 254 | 344 |
gemini-3.8-live-extended-thinking(high) | 4,183 | 466 | 226 | 610 |
1往復あたりの平均トークン数(一括送信75セッション)です。当社のシステムプロンプトは約660トークンですが、Extended Thinking はテキスト入力が4,000トークン台で返ってきます。モデル側で足されるプロンプトが約3,000トークンあり、これがユーザーの入力として課金されるようです。単価は $0.75/100万なので1往復あたり $0.002〜0.003 で済みますが、ツール呼び出しで往復が増える S4 では入力が7,000〜10,000トークンに膨らみ、1往復 $0.02〜0.03 と gpt-realtime-2.1 に近づきました。
もう1点、Gemini 3.8 Live(Extended Thinking ではない方)も思考トークンを返します。1往復あたり180トークン前後で、公式のモデルカードにある「interleaved reasoning(会話に織り込んだ推論)」が動いている証拠です。額にすると $0.0008 程度で、実用上は無視できます。
なお、gpt-realtime-2.1 / mini も reasoning_tokens を返しますが、output_tokens の合計には含まれておらず、料金ページにも記載がありません。今回の実額には含めていません(含めても1往復 $0.001 未満)。
4. 結果②:声が返るまでの時間は、マイクと同じ速度で送れば両社 1.5〜1.9 秒で横並び
利用者が体感する待ち時間として、発話の最後の音声を送ってから AI の最初の音声が届くまで(TTFA)を測りました。サーバー側 VAD の終端判定(無音を検知して「話し終わった」と判断する時間)を含みます。
送信方法で結果が大きく変わったので、両方載せます。
モデル | 一括送信(音声を瞬時に流し込む) | 実時間送信(マイクと同じ 100ms ごと) |
|---|---|---|
gpt-realtime-2.1 | 1.72秒 | 1.60秒 |
gpt-realtime-2.1-mini | 1.77秒 | 1.50秒 |
gemini-3.8-live | 4.40秒 | 1.74秒 |
gemini-3.8-live-extended-thinking(low) | 4.13秒 | 1.90秒 |
gemini-3.8-live-extended-thinking(high) | 3.95秒 | 1.85秒 |
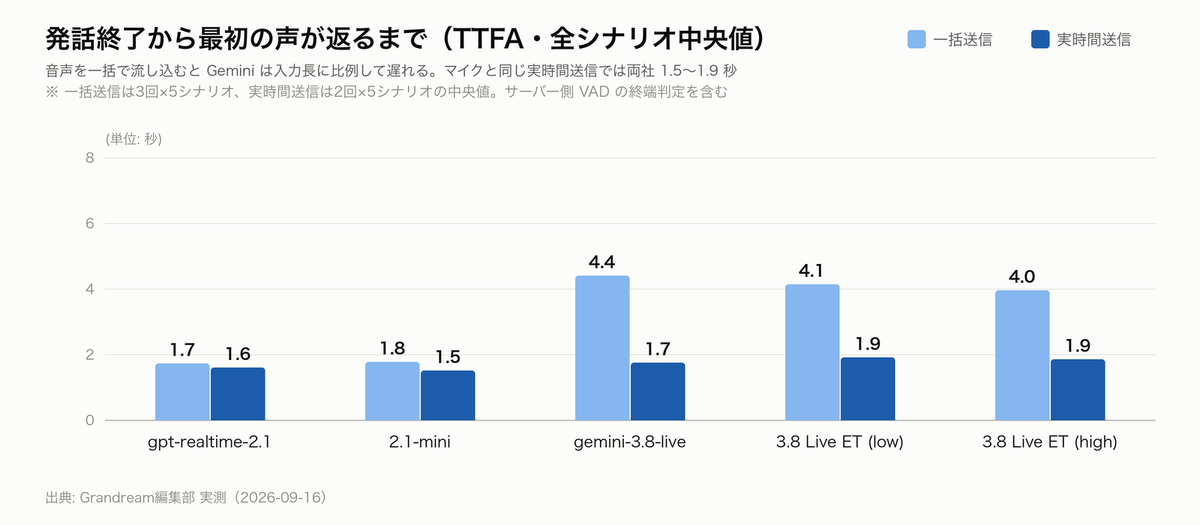
一括送信では Gemini が 4 秒台で OpenAI の 2.5 倍遅く見えます。しかし内訳を見ると、Gemini の TTFA は入力音声の長さに比例して伸びていました(3.6秒の質問で 2.5秒、13.7秒の質問で 5.3秒)。Gemini はサーバー側で音声を実時間に近い速度で処理しているため、ファイルを一気に流し込むとその分だけ待たされます。OpenAI は入力の長さに関係なく 1.7 秒前後でした。
実際の通話ではマイクの音声は実時間でしか届かないので、実時間送信の数字が実態です。その条件では Gemini 3.8 Live 1.74秒、Extended Thinking 1.85〜1.90秒、gpt-realtime-2.1 1.60秒、mini 1.50秒と、5構成すべてが 1.5〜1.9 秒に収まりました。Extended Thinking は「考えながら話す」ため、思考レベルを high にしても最初の声が遅くなっていません。
接続確立(WebSocket を開いてセッション設定が完了するまで)は Gemini が 0.42〜0.48秒、OpenAI が 0.72〜0.89秒で、Gemini の方が速いです。1通話に1回しか発生しないので、体感への影響は小さいです。
「考えながら話す」の副作用:応答全体が終わるまでは長い
TTFA とは別に、応答の生成が完了するまでの時間(OpenAI は response.done、Gemini は generationComplete の到着)も測りました。実時間送信の中央値です。
モデル | S1 基本応答 | S2 英数字復唱 | S3 計算 | S4 予約ツール | S5 言語切替 |
|---|---|---|---|---|---|
gpt-realtime-2.1 | 3.8秒 | 4.8秒 | 3.3秒 | 5.8秒 | 3.7秒 |
gpt-realtime-2.1-mini | 3.0秒 | 2.8秒 | 3.0秒 | 3.8秒 | 2.6秒 |
gemini-3.8-live | 3.6秒 | 5.4秒 | 2.9秒 | 6.1秒 | 3.0秒 |
gemini-3.8-live-extended-thinking(low) | 8.2秒 | 14.7秒 | 6.9秒 | 21.8秒 | 11.6秒 |
gemini-3.8-live-extended-thinking(high) | 10.3秒 | 17.1秒 | 8.7秒 | 16.3秒 | 11.9秒 |
OpenAI と Gemini 3.8 Live は、10秒分の音声を3〜6秒で生成し終えます(再生より速い)。Extended Thinking は生成完了が音声の再生時間とほぼ一致しており、話す速度に合わせて逐次生成していることが分かります。利用者にとっては「最初の一声は速いが、次の発話ができるのは話し終わってから」で、S4 の予約ツール呼び出しでは「確認しますね」と言ってから実際にツールが呼ばれるまで 6〜9秒かかりました(3.8 Live と OpenAI は 2〜4秒)。
5. 結果③:応答の中身は Gemini が計算に強く、OpenAI 上位が言語切替とツール呼び出しで安定
5シナリオ × 5構成 × 5回 = 125セッションの書き起こしを、シナリオごとに採点しました。
シナリオ | 見たこと | gpt-realtime-2.1 | gpt-realtime-2.1-mini | gemini-3.8-live | ET(low) | ET(high) |
|---|---|---|---|---|---|---|
S1 基本応答 | 診療時間を正しく答えた | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 |
S2 英数字の復唱 | 全桁を正しく聞き取った | 5/5 | 5/5 | 5/5 | 4/5※ | 5/5 |
S2 英数字の復唱 | 一字ずつ区切って読んだ | 5/5 | 4/5 | 5/5 | 2/5 | 4/5 |
S3 計算と複合質問 | 合計 7,500円 と答えた | 0/5 | 0/5 | 5/5 | 5/5 | 5/5 |
S4 予約ツール呼び出し | 正しい引数でツールを呼んだ | 5/5 | 1/5 | 5/5 | 5/5 | 3/5 |
S5 言語切替 | 英語部分は英語・日本語部分は日本語で答えた | 5/5 | 0/5 | 4/5 | 2/5 | 3/5 |
計算:OpenAI の2モデルは10回すべて「4,500円」と間違えた
「大人2人と子ども1人、大人の初診料3,000円、子どもは半額」の合計は 3,000 × 2 + 1,500 = 7,500円です。gpt-realtime-2.1 と mini は 10回とも 4,500円 と答えました。内訳を「大人が3,000円、子どもが1,500円」と説明しているので、「大人2人」を聞き落としたか、掛け算を省いています。一方、Gemini は Extended Thinking でない 3.8 Live を含めて 15回すべて 7,500円 でした。Google が Big Bench Audio(音声での推論)97.7% を強調するのは、この差の裏付けと読めます。
土曜午後の休診は、5構成すべてが正しく答えました。
英数字:聞き取りは全員正確、Extended Thinking は「まとめ読み」しがち
予約番号 A7392B と電話番号 090-1234-5678 は、読み上げた24セッションすべてで誤りなく聞き取れました(※Extended Thinking(low)の1回は予約番号を読んだところで応答が終わり、電話番号に到達しませんでした)。両社が主張する英数字の精度は、日本語の音声合成入力でも確認できました。
差が出たのは読み上げ方です。システムプロンプトで「一字ずつはっきり」と指示していますが、Extended Thinking(low)は5回中3回、「A 7392 B」「09012345678」とまとめて読みました。high は1回、mini も1回、電話番号を「090、1234、5678」と3〜4桁ずつまとめています。gpt-realtime-2.1 と Gemini 3.8 Live は毎回一字ずつ区切りました。Gemini 3.8 Live は「えー、なな、さん、きゅう」とひらがなの発音で書き起こされる回が2回あり、電話越しの聞き取りやすさという点では「A、7、3」と読む OpenAI の方が安定していました。
ツール呼び出し:gpt-realtime-2.1 と Gemini 3.8 Live が安定、mini は日付を間違える
「明日の午後3時に山田で予約、電話番号は 080-1111-2222」を book_appointment(name, datetime, phone) に落とす課題です。システムプロンプトに「今日は2026年9月16日(水)」を与えています。
- gpt-realtime-2.1:5回すべて正しい引数。「予約の登録をして確認しますね」と一声かけてからツールを呼び、結果を予約番号込みで返した
- gpt-realtime-2.1-mini:正解は5回中1回。3回は日付を「9月16日(今日)」や「17時」と間違え、1回は「フルネームを教えてください」とツールを呼ばなかった。電話番号も「2 2 0、2 2 2 2」と余計な桁を復唱した
- gemini-3.8-live:5回すべて正しい引数。実時間送信では発話終了から1.8秒でツールを呼び、5構成で最速
- Extended Thinking(low):5回すべて正しい引数。ただし呼び出しまで 6〜8秒
- Extended Thinking(high):3回は正しい引数。2回は「かしこまりました、ご予約の内容を確認します」と述べたあと、5秒待ってもツール呼び出しが届かず計測を打ち切った
Gemini は関数を既定で**非同期(NON_BLOCKING)**として扱います。ツールの結果を返す際に「すぐ伝える(INTERRUPT)」「手が空いたら(WHEN_IDLE)」「黙って覚える(SILENT)」を指示でき、今回は INTERRUPT を指定しました。この指定を付けないと、Extended Thinking は「少々お待ちください」と言ったまま予約番号を伝えないセッションがありました。
言語切替:英語→日本語の切り戻しは gpt-realtime-2.1 が完璧、mini は英語のまま
「Hello, do you have an English speaking dentist? あと、駐車場はありますか。」に対して、理想は前半を英語・後半を日本語で返すことです。
- gpt-realtime-2.1:5回すべて「Yes, ... on Tuesdays and Thursdays. 駐車場は提携コインパーキングが...」と切り替えた
- gpt-realtime-2.1-mini:5回とも英語で押し切り、駐車場の案内も英語。1回は駐車場に答えなかった
- gemini-3.8-live:5回中4回切り替え。1回は英語のまま
- Extended Thinking(low):5回中2回。3回は英語のまま
- Extended Thinking(high):5回中3回。2回は最初から日本語で答えた(英語部分にも日本語で返答)
Google は「97言語を会話の途中で自動判別」を掲げていますが、1つの発話の中に2言語が混ざる場面では、Extended Thinking はどちらか一方の言語に寄せる傾向がありました。
6. 実装して分かった仕様差
記事にする際に確かめた、公式ドキュメントだけでは分かりにくい点です。
項目 | Gemini 3.8 Live / Extended Thinking | OpenAI Realtime API(gpt-realtime-2.1) |
|---|---|---|
手動ターン制御 | 3.8 Live は自動 VAD を無効化できない( |
|
思考レベル | Extended Thinking は |
|
応答の完了通知 |
|
|
非同期ツール | 関数は既定で NON_BLOCKING。結果に | 通常の function calling。呼び出し→結果→ |
入力音声 | 16kHz PCM(他のレートは自動変換) | 24kHz PCM が既定 |
セッション上限 | 音声のみ15分・映像込み2分(セッション再開で延長可) | 会話コンテキスト 128k トークン、超過時は自動切り詰め |
無料枠 | あり(Live API の無料ティアで 3.8 Live / Extended Thinking とも利用可) | なし |
7. どちらを選ぶか
今回の条件(歯科医院の受付AI・日本語・1問1答)で見えた選び分けです。
- 料金を最優先するなら Gemini 3.8 Live。1往復 $0.005 で gpt-realtime-2.1 の4分の1、mini と同額。計算を含む質問への正答率が高く、ツール呼び出しも安定。英数字は「えー、なな」と読む回があるので、読み上げ形式をプロンプトで詰める必要がある
- 英語と日本語が混ざる窓口や、複雑な予約フローの確実性を重視するなら gpt-realtime-2.1。言語切替 5/5・ツール引数 5/5 と最も安定。ただし1往復 $0.02 と最も高く、応答も長めで、掛け算を含む計算は10回中0回だった。金額計算はモデルに任せずツールに出す設計が必要
- gpt-realtime-2.1-mini は今回の条件では非推奨。安いが日付の取り違え、日本語への切り戻し失敗、余計な桁の復唱が目立った
- Extended Thinking は「即答の速さ」は 3.8 Live と同じだが、話し終わるまでとツール呼び出しまでが長い。1往復あたり隠れた入力トークン約3,000が乗り、ツール往復では gpt-realtime-2.1 に近い額になる。多段の裏処理を口頭で実況させたい業務向けで、1問1答の受付には 3.8 Live で足りる
- GPT-Live-1($0.05/分・全二重) は今回計測していない。無音時間も課金されるため、1問1答が中心の受付では割高になりやすく、割り込みや相槌の自然さが要件になる用途で候補になる
8. 計測の限界
- n=5(一括3回 + 実時間2回)の軽量計測。1回の外れ値で採点が動くので、1〜2回差は誤差と読んでください。0/5 と 5/5 のように割れた項目だけを差として扱っています
- **入力は音声合成(macOS Kyoko)**で、人間の発話に比べて明瞭です。雑音・言い直し・方言への耐性は測っていません
- 応答の評価は API が返す書き起こしテキストで行いました。声の自然さ・イントネーションは評価していません
- OpenAI は
reasoning設定を既定のまま、Gemini Extended Thinking は low と high のみ(medium は未計測)です - 1問1答のみ。複数ターンの会話では OpenAI の履歴再送コストと Gemini の思考トークンの積み上がりが変わります
- 単一拠点(日本)からの平日朝の計測で、ピーク時の挙動やテール遅延は見ていません
- gpt-realtime-2.1 の
reasoning_tokensの課金有無は公式に記載がなく、実額に含めていません
9. まとめ
- Google は2026年9月15日、Gemini 3.8 Live(コスト効率・97言語・非同期ツール)と 3.8 Live Extended Thinking(考えながら話す)を公開。音声入力 $3・出力 $12/100万トークンで、OpenAI Realtime API($32 / $64)の 10分の1の単価
- 同じ日本語質問音声 125セッションの実測では、1往復の実額は Gemini 3.8 Live $0.005、gpt-realtime-2.1 $0.021、mini $0.007。定価差10倍が実額では4倍に縮むのは、OpenAI のプロンプトキャッシュと Gemini の思考トークン・隠れた入力のため
- 声が返るまでの時間は、マイクと同じ速度で送れば5構成すべて 1.5〜1.9秒。音声を一括で流し込む計測では Gemini が不利に見えるので、比較記事の数字は送信方法を確認する必要がある
- 計算問題は Gemini が 15/15 正解、OpenAI は 0/10。逆に 1発話内の英日切替とツール引数の正確さは gpt-realtime-2.1 が 5/5 で最も安定
- Extended Thinking は最初の一声は速いが、話し終わりとツール呼び出しが遅く、1往復の入力に約3,000トークンが上乗せされる。1問1答の受付なら 3.8 Live で十分
音声 API の選定は「どちらが安いか」だけでは決まりません。自社の窓口で守らせたい振る舞い(計算・英数字・言語・ツール)を数本の音声ファイルにして、両 API に同じものを流すのが確実です。今回の125セッションはその出発点として、Gemini 3.8 Live が「安くて計算に強い既定」になりうること、そして言語切替とツールの確実性ではまだ gpt-realtime-2.1 が一段上にいることを示しています。
出典(一次情報)
- Introducing Gemini 3.8 Live and 3.8 Live Extended Thinking | Google
- Gemini Developer API Pricing | Google AI for Developers
- Gemini 3.8 Live model card | Google AI for Developers
- Live API capabilities guide | Google AI for Developers
- Tool use with Live API | Google AI for Developers
- Pricing | OpenAI API
- Realtime conversations | OpenAI API
- Voice latency and cost | OpenAI API
- GPT-Live-1 Model | OpenAI API
- Speech to Speech Leaderboard | Artificial Analysis
- 実測値は編集部が2026年9月16日に Gemini Live API / OpenAI Realtime API を直接呼び出して取得(5構成 × 5シナリオ × 5回 = 125セッション)
関連記事


Grandream
株式会社グランドリーム
AI・システム開発のプロフェッショナルチームです。AIエージェント・業務自動化・Webシステム開発などを手がけています。