

Grandream
ドキュメントの「正本」を1箇所に固定する — Claude Code で設計書が二重管理になるのを検査で止める
生成AI(Claude CodeやCursorなど)による仕様駆動開発が定着した開発現場において、新たなボトルネックが急浮上しています。それは、「AIによるドキュメント生成が爆速になった結果、ドキュメントの多重管理・数値や仕様の散在が発生し、人間側の整合性チェックコストが肥大化する」という問題です。
結論から言うと、この問題を解決するには**「正本(Single Source of Truth)」を規約ファイルに固定し、重複をCI(継続的インテグレーション)で機械的に弾く構造**が必要です。
本記事では、AIが設計書を散らかしてしまう原因を紐解き、CLAUDE.mdを用いた正本固定のルール設計と、二重管理を機械的に止めるスクリプト(check-docs)の実装例を解説します。これにより、ドキュメント量が半減し、AIの恩恵を最大限に引き出せるようになります。
症状:AIに設計書を書かせると「同じ数値」が散乱し、レビュー工数が爆発する
AIに仕様書や設計書を書かせていると、様々なファイルに同じ情報が点在してしまう事象に直面していないでしょうか。
AIは親切心から「どこにでも数値を書く」
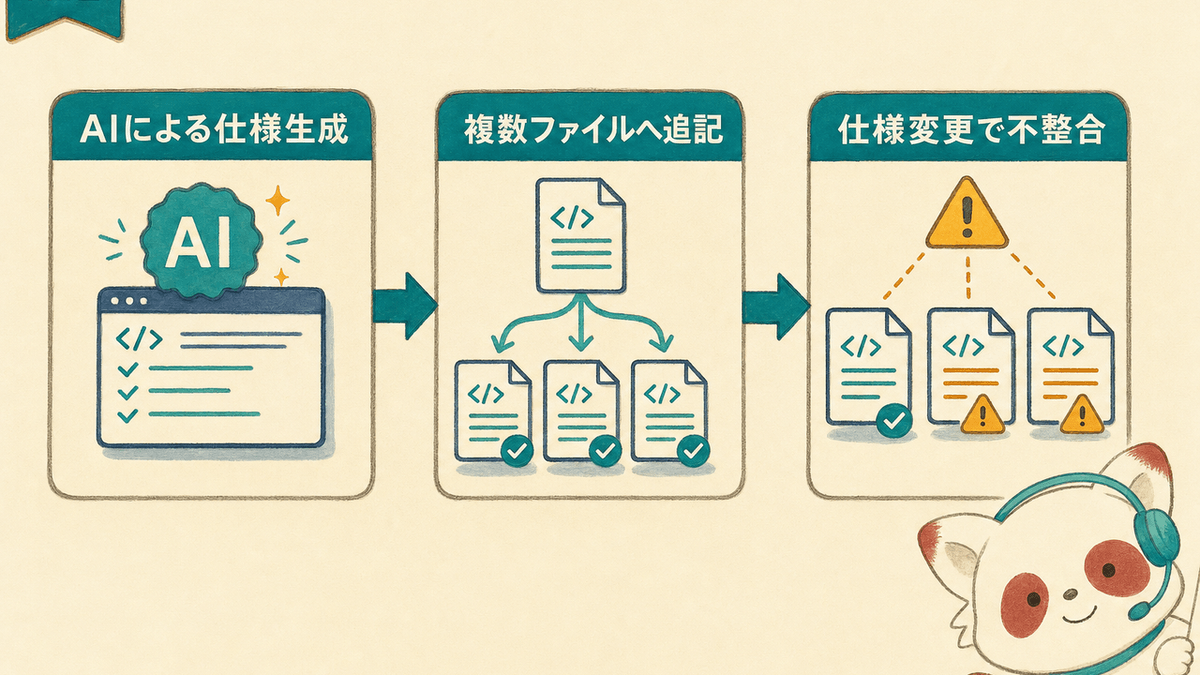
Claude CodeなどのLLMに設計文書の作成や更新を依頼すると、AIは「親切心」から文脈を完結させようとします。例えば、新しいAPIを追加するタスクを与えた場合、AIは要件定義書、詳細設計書、さらにはタスク管理用のMarkdownにまで、APIのパラメータやレスポンスの型、関連する画面数などを丁寧に追記してしまいます。
結果として、「ユーザー一覧取得APIの戻り値」という単一の仕様が、複数のファイルに重複して記述される二重管理の状態が生み出されます。
1箇所の仕様変更で発生する「整合合わせ」の恒常コスト
この二重管理が牙を剥くのは、仕様変更が発生したタイミングです。 あるAPIのパラメータが1つ追加された際、AIが追従漏れを起こすと、「要件定義書にはパラメータが3つ、詳細設計書には4つ記載されている」といった矛盾が発生します。
プルリクエスト(PR)のレビュー時、人間は「一体どれが最新で正しい仕様なのか」を照合・推測しなければならず、無駄な整合合わせに時間が溶けていきます。AIによってコーディング速度が上がったにもかかわらず、ドキュメントのレビュー工数が爆発してしまうのです。
原因:何が「正本(Single Source of Truth)」かが未定義であること
なぜAIは情報を散らかしてしまうのでしょうか。その根本原因は、プロジェクトにおけるSingle Source of Truth(SSOT:信頼できる唯一の情報源)、つまり「正本」がどこか定義されていないことにあります。
曖昧なドキュメント構造がAIの重複生成を誘発する
「決定事項」「要件」「APIの型」「DBのカラム」「デザインの色」といった情報のそれぞれについて、「どのファイルに書かれるべきか」という役割分担が曖昧なままだと、AIはコンテキストウィンドウ内に読み込まれた情報を頼りに、適当なファイルへ手当たり次第に書き込んでしまいます。 そもそもズレが生じるのは、様々な情報が各資料に点在しているからです。点在させないような構造にすれば、統一させる手間はなくなります。
「注意深く書く」という属人ルールがAI運用で破綻する理由
この問題に対して、「プロンプトで『重複して書かないこと』と指示する」「運用ルールをドキュメントに書いておく」といったアプローチをとる現場もあります。 しかし、こういった属人的・精神論的なルールはAI運用ではすぐに破綻します。AIはプロンプトの指示を忘却したり、文字数の都合で無視したりするためです。人間側も常にプロンプトを完璧に書き続けることは不可能です。
必要なのは、ルールではなく「構造」による解決です。
解決策:正本テーブルを規約ファイル(CLAUDE.md)で固定し、参照を1行にする
具体的な解決策として、CLAUDE.md を活用して正本の場所を定義し、実体の記述を1箇所に絞る設計思想を導入します。CLAUDE.mdは、Claude Codeがプロジェクトルートで自動認識し、セッション開始時に必ず参照されるプロジェクト固有の規約ファイルです。
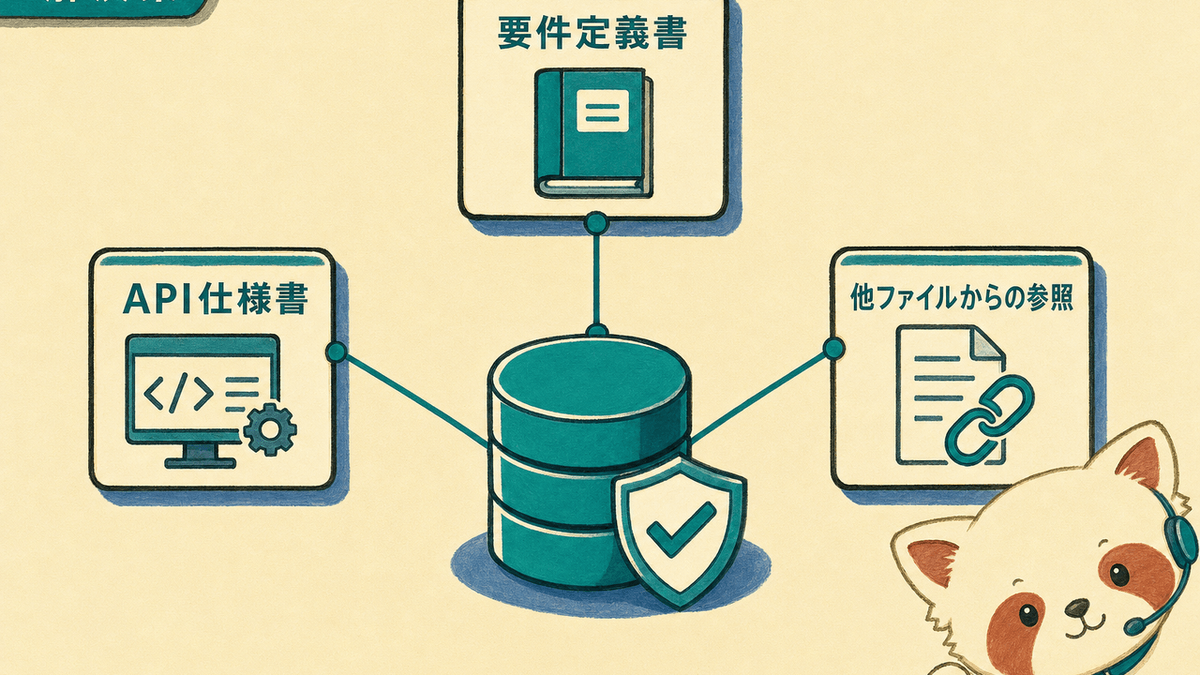
決定・要件・API・DB・UIカラーの正本マッピングテーブル
まず、CLAUDE.md 内に以下のような「正本マッピングテーブル」を明記します。
# ドキュメント管理規約 (Single Source of Truth)

当プロジェクトでは、情報の重複を防ぐため、以下の通り情報の「正本」となるファイルを定めます。AIは情報を追記・修正する際、必ず以下の正本ファイルを更新してください。

| 情報の種類 | 正本となるファイルパス |
| :--- | :--- |
| プロジェクトの決定事項 | `docs/decisions.md` |
| 業務要件・ユースケース | `docs/requirements.md` |
| APIの型定義・インターフェース | `docs/api-specs.md` |
| データベースのカラム定義 | `docs/db-schema.md` |
| UIカラー・デザイン定義 | `docs/design-tokens.md` |
このように、どの情報がどこに存在するべきかをAIに明確に認識させます。
他ファイルには「実体」を書かせず「リンク」のみを許可するルール設計
正本を定めたら、それ以外のファイルでは「具体的な数値や仕様を書かない」というルールを徹底します。 例えば、フロントエンドの実装タスクをまとめたファイルでAPIの仕様に言及する必要がある場合、以下のように実体を書くのはNGです。
NGな書き方(実体を書いてしまう)
- ユーザー一覧取得APIを実装する。戻り値は
id,name,
OKな書き方(リンクのみを許可する)
- ユーザー一覧取得APIを実装する。戻り値の詳細は
docs/api-specs.mdを参照。
他ファイルには行き先を示す1行のリンクだけを書かせることで、仕様が変更された際も正本ファイル(docs/api-specs.md)のみを更新すれば整合性が保たれる構造を作ります。
実装:二重管理を機械的に防ぐ「check-docs」スクリプトとCI
しかし、ルールを定めただけでは絵に描いた餅です。AIも人間も時にルールを破ります。そこで、DevOpsの思想に則り、定めたルールを強制させるための静的検査スクリプト(check-docs)を実装します。
検査1:リンク切れと未定義の参照の検知
検査スクリプトの1つ目の役割は、正本へのリンクが正しく機能しているかの確認です。 Markdownファイル内の相対パスやファイル名をパースし、実際にそのファイルが存在するかをチェックします。存在しないファイルを参照している場合はエラーとし、AIのハルシネーションによる存在しないドキュメントへのリンク切れを防ぎます。
検査2:正本テーブル以外の重複記述・「腐る数値(件数・画面数)」の静的検出
2つ目の役割は、正本として許可されていないファイルに「実体」が書かれていないかの検出です。 例えば、要件定義書(docs/requirements.md)以外のファイルに対して、シェルスクリプトやNode.js等で以下のような「腐りやすい数値」を機械的に検出します。
#!/bin/bash
# 要件定義書以外に「○件」「○カラム」と書かれている行を検出
grep -rnE "[0-9]+(件|カラム|画面)" docs/ \
  | grep -v "docs/requirements.md" \
  && echo "エラー: 正本以外に具体的な数値が書かれています" && exit 1
これらの具体的な数値が正本以外のファイルに記述されている場合、スクリプトはエラー(終了コード1)を出力します。
PR時にGitHub Actionsでブロックし、整合性を自動担保する
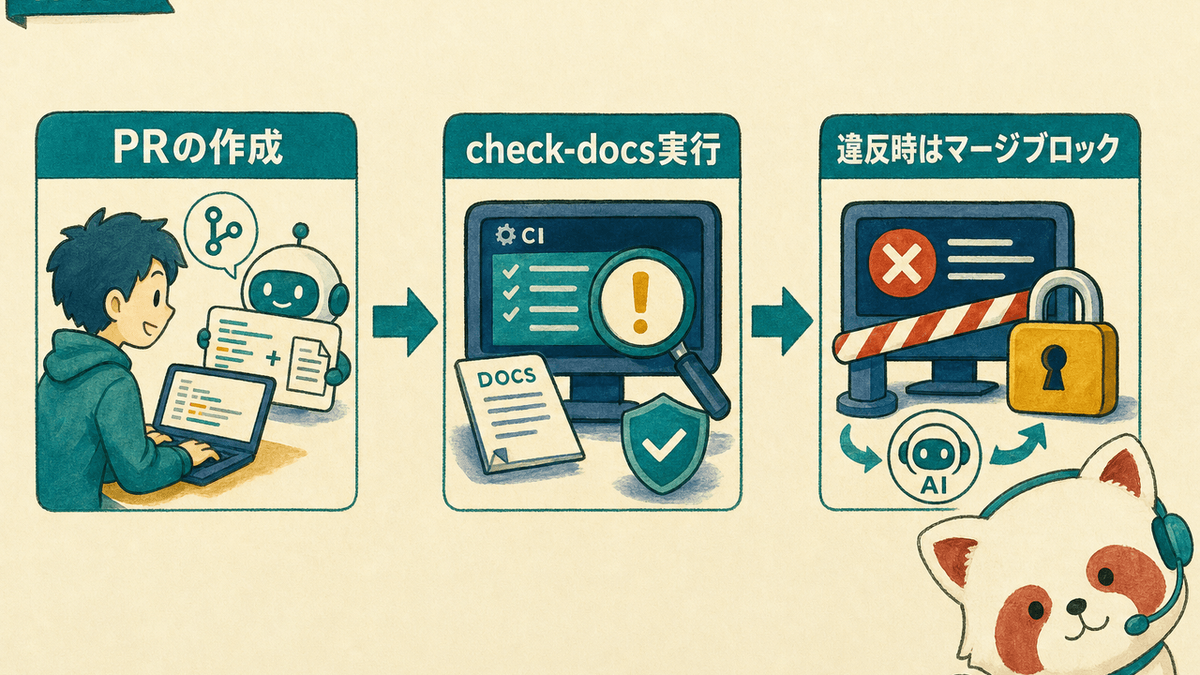
作成した check-docs スクリプトを、GitHub ActionsなどのCI(継続的インテグレーション)パイプラインに組み込みます。
PRが作成されたタイミングでスクリプトが走り、ドキュメントの二重管理や腐る数値が検出された場合はCIが失敗(レッド)となり、マージをブロックします。 これにより、PRレビューの段階で人間が整合性を確認する必要がなくなり、AI自身に「CIが落ちたので、エラーメッセージに従って自己修正して」と指示するだけで、ガードレールに沿った自動修正サイクルが回るようになります。
結果と実例:文書量を半減させ、スプリント計画を廃止できた理由
この「正本固定 + CI検査」の仕組みを実際のプロジェクトに導入した結果、劇的な効果が得られました。
440行の機能一覧を1表に集約、読むべき文書を2本へ削減
各所に散在していた仕様記述を機械的に排除し、正本へ寄せるリファクタリングを実施しました。 結果として、各ドキュメントに分散し440行にも肥大化していた機能一覧が1つの表に集約されました。エンジニアが実装前に読んで確認すべきドキュメントは、実質的に2本にまで半減し、認知負荷が大きく下がりました。
実装順序の正本はGitHub Projectsへ一本化(重複ドキュメントの完全廃止)
さらに、ドキュメントの断捨離も進めました。 それまではMarkdownで「スプリント計画書」を作成し、タスクの実装順序や進捗を管理していましたが、これも二重管理の温床でした。 そこで、「動的な状態や実装順序の正本は Issueトラッカー(GitHub Projects)である」と定義し、Markdownによるスプリント計画書を完全に廃止しました。これにより、進捗管理とドキュメントの同期という無駄な作業が消滅しました。
まとめ:AI時代のドキュメント管理は「ルール+機械的検査」で成立する
AIはコードだけでなくドキュメントも爆速で生成してくれますが、放っておけばプロジェクトは情報の重複と不整合で溢れかえってしまいます。AIの恩恵を最大限に受けるためには、「注意深く書く」といった属人的な対応ではなく、以下のアプローチが不可欠です。
CLAUDE.mdに情報種別ごとの正本(Single Source of Truth)をマッピングする- 正本以外のファイルには、リンク1行のみを記述させる
check-docsスクリプトとCIを用いて、違反を機械的にブロックする
AI時代のドキュメント管理は「ルール+機械的検査(ガードレール)」があって初めて成立します。まずは自プロジェクトの CLAUDE.md に正本テーブルを定義し、簡単な正規表現によるCIチェックから導入することをおすすめします。
関連記事


Grandream
株式会社グランドリーム
AI・システム開発のプロフェッショナルチームです。AIエージェント・業務自動化・Webシステム開発などを手がけています。