

Grandream
Jevの精度はGPT-5.6 Lunaと並んだ|電話100件を仕分けさせた実測
歯科医院にかかってきた電話100件を、TypeSafe AIのJevとOpenAIのGPT-5.6 Lunaに同じ分類体系で仕分けさせました。用件、最初の転送先、苦情かどうか、緊急度の4つを同時に判定させています。
正答率はほぼ同一でした。用件はどちらも97%、転送先もどちらも98%、苦情の検出はどちらも99%です。
差が出たのは速度と費用でした。1件あたりの応答時間はJevが237ミリ秒、Lunaが1,371ミリ秒で、費用は$0.000056と$0.000260でした。
4つの判定を1リクエストで返させる
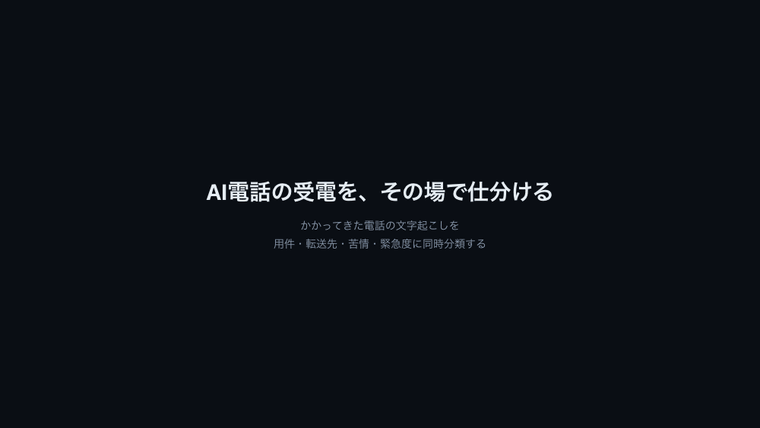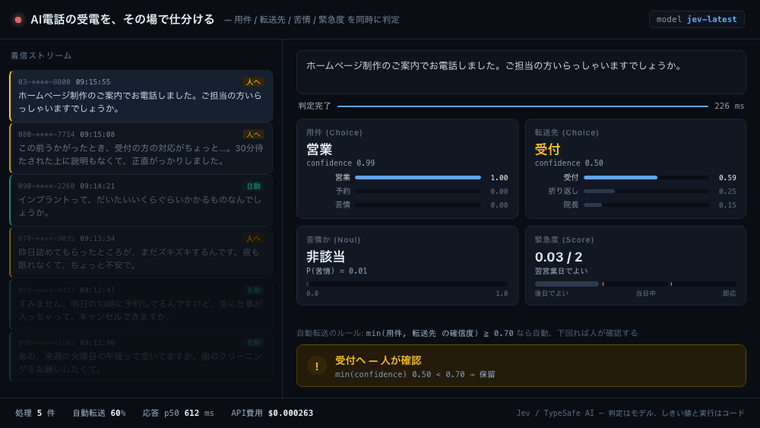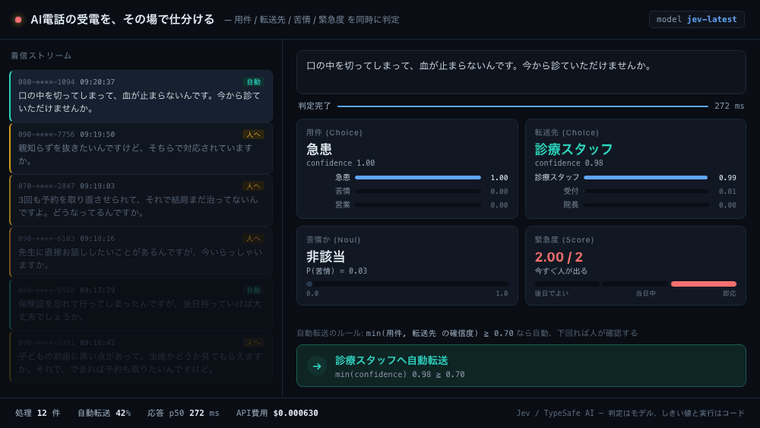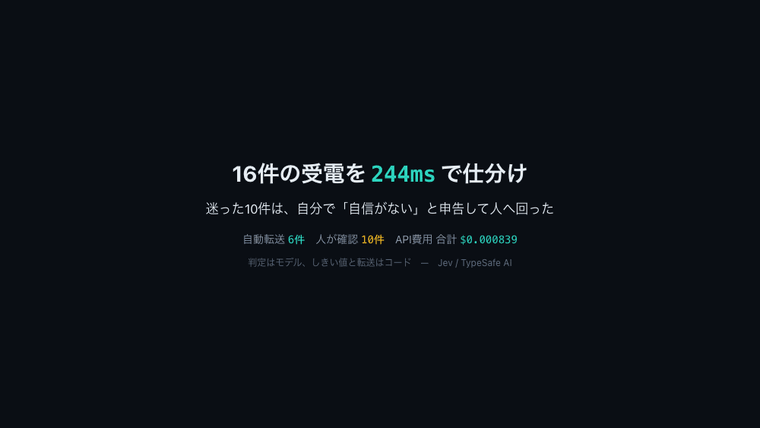
題材はAI電話の受付です。電話の文字起こしを読み、用件を8種類、転送先を5つから選び、苦情が含まれるかを判定して緊急度を3段階で採点します。この4つを1回の呼び出しで返させます。
100件の発話は、先に正解ラベルを決めてから台詞を書きました。書いてから判定を付けると、書き手の解釈があとから正解に化けてしまうためです。予約20件、予約変更14件、診療相談18件、費用支払14件、苦情10件、急患8件、営業6件、その他10件という配分にしています。
うち16件は、複数の読みが成り立つよう意図的に書きました。「ホワイトニングの料金表はありますか。あと効果はどれくらい持ちますか」は費用の問い合わせとも診療内容の相談とも取れます。この16件は許容する答えを複数置き、厳密な集計からは外しました。
発話もラベルも同じ書き手が作っているので、これは実地の精度ではなく「意図した読み方と一致するか」の測定です。そこは割り引いて読んでください。
正答率は4項目とも並ぶ
用件 | 転送先 | 苦情 | 緊急度 | 4項目すべて | |
|---|---|---|---|---|---|
Jev | 97% | 98% | 99% | 94% | 89% |
GPT-5.6 Luna | 97% | 98% | 99% | 93% | 89% |
4項目すべてを当てた割合まで89%で一致しました。曖昧な16件を除いた集計でも、Jevが89.3%、Lunaが90.5%です。
外した内容も似ています。Jevが転送先を外したのは、苦情の宛先を院長ではなく診療スタッフや会計事務と判定した2件でした。誰が謝るべきかの判断は、症状の相談や金銭の処理と紛らわしく、人でも意見が割れる境界でした。
確信度は、校正の数字より当たり外れの見分けで差が出る
両者とも判定に確信度の数値を添えて返します。用件と転送先の200判定について、申告した確率と実際の正解率を突き合わせました。
期待校正誤差はLunaが0.022、Jevが0.096です。数字だけならLunaの校正が良好です。ところが、正解と不正解を確率で並べ替えられるかを見ると逆転します。AUCはJevが0.926、Lunaが0.61でした。
理由は分布にあります。Lunaは200判定のうち182件で0.9以上と答えました。ほとんどの判定で0.9以上を出すので、申告値と実測値の差は小さくなる代わりに、当たりと外れをほとんど見分けられません。Jevは0.2から1.0まで散らばり、低く出した判定は実際に外れやすくなっています。
しきい値を引いて自動と人手を分ける用途では、この見分けの差が効きます。0.70で切ると次のようになりました。
自動に回した | その転送先が正しかった | 人へ回した | |
|---|---|---|---|
Jev | 76件 | 76件すべて | 24件 |
GPT-5.6 Luna | 97件 | 97.9% | 3件 |
Lunaは97件を自動化して2件を取りこぼします。Jevは76件に絞る代わりに取りこぼしゼロでした。どちらが良いかは、誤転送1件のコストと人手24件のコストのどちらが高いかで決まります。
Jevの申告にはもうひとつ特徴があります。すべての分位で、申告した確率より実際の正解率が上回っていました。0.54と出した判定は実際に全問当たり、0.75と出した判定も全問当たっています。一貫して低めに出るので、しきい値を引いても通しすぎにはなりません。
読みが割れる電話では、Jevが上回る
意図的に曖昧に書いた16件だけを見ると順位が入れ替わります。4項目すべて正解した割合はJevが87.5%、Lunaが81.3%、転送先だけを見るとJevが16件すべて正解でLunaは87.5%でした。
はっきりした電話ではLunaがわずかに強く、複数の読みが成り立つ電話ではJevが許容内に収まりやすい傾向があります。ただし16件での観測なので、参考程度にとどめてください。
速度と費用の差は埋まらない
応答 p50 | p95 | 100件を並列6で完了 | 1件あたり費用 | |
|---|---|---|---|---|
Jev | 237 ms | 563 ms | 4.8 秒 | $0.000056 |
GPT-5.6 Luna | 1,371 ms | 2,630 ms | 27.2 秒 | $0.000260 |
速度で6倍、費用で5倍の差があります。同じ100件を流し切るまでの時間は4.8秒と27.2秒でした。
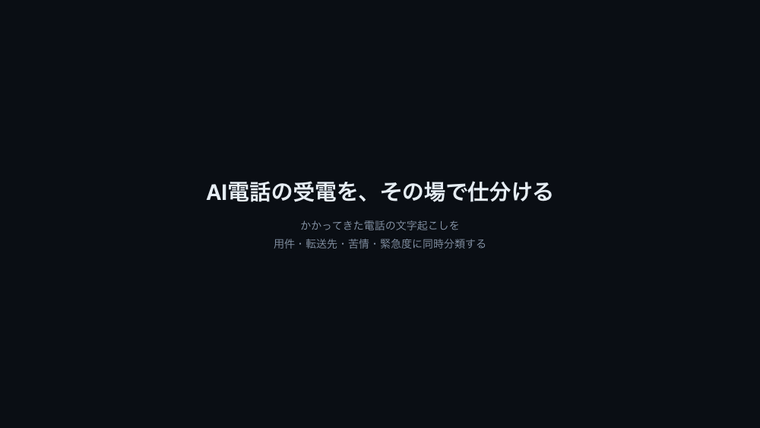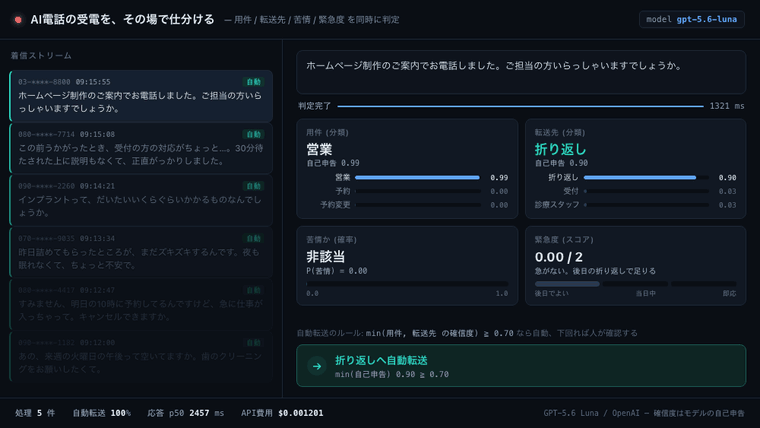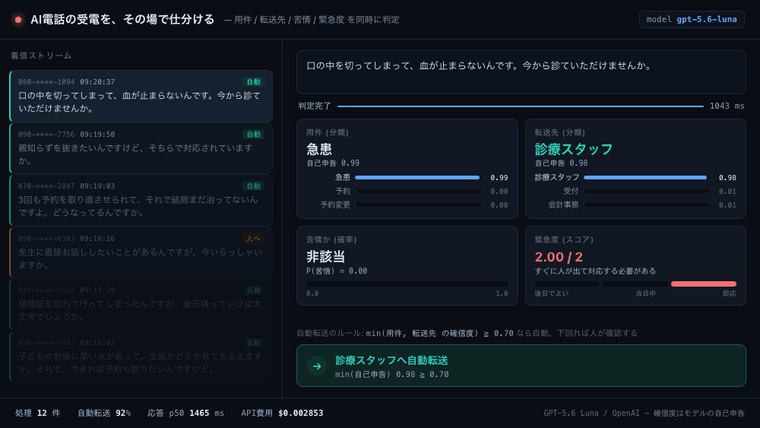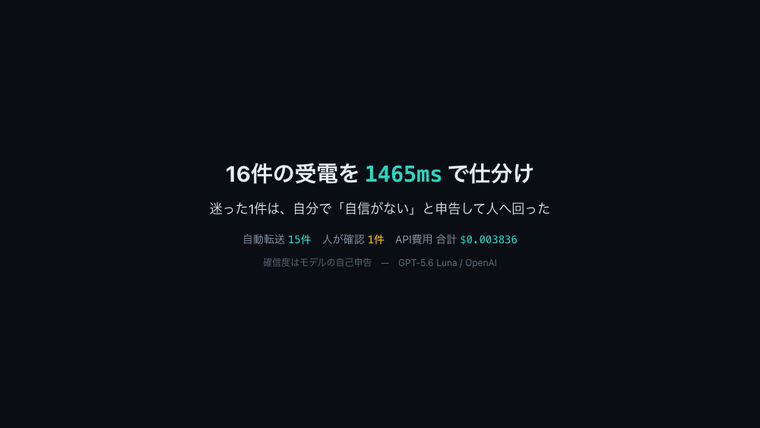
下は同じデモをLunaで動かした様子です。判定のレイテンシがそのまま画面の待ち時間となり、通話中に相手を待たせずに返す用途では、この遅延が体験の差に直結します。
なおJevに上位モデルはありません。APIのモデル一覧にはjev-latestとjev-previewの2つが並びますが、どちらもサーバ側は同じjev-1.13.0を返します。同じ入力で2回叩いたときのばらつきと、latestとpreviewの差を比べたところ、大きさも選択の変化も区別がつきませんでした。性能の高い版へ載せ替えて精度を上げることはできません。
Jevの精度は、プロンプト設計で決まる
ここまでの数字は、プロンプトを2回書き直したあとのものです。最初に書いたプロンプトでのJevは、緊急度の正答率が62.5%、営業電話の転送先が16.7%しかありませんでした。当てずっぽうより悪い数字です。
緊急度の3段階を、最初はこう書いていました。「急がない。後日の折り返しで足りる」「当日中に折り返せばよい」「すぐに人が出て対応する必要がある」。段階が重なっています。Jevは各段階を互いに参照せず独立して評価するため、「当日中に折り返せばよい」がほとんどの電話に対して部分的に真になってしまいます。その結果、駐車場の台数を聞くだけの電話にも緊急度0.63が付きました。
転送先はもっと分かりやすい欠陥でした。受付、診療スタッフ、会計事務、院長の4つは「誰が受けるか」の説明なのに、折り返しだけが「今すぐ人が出る必要はなく、後で折り返せばよい」という時間の説明になっていました。1つの質問に2つの軸が混ざっています。各選択肢が独立に評価されるので、税理士事務所の売り込みに対して「料金・保険・書類の処理=会計事務」が部分的に真に見えます。
段階を排他的に書き直し、選択肢を「誰が受ける電話か」の1軸に揃えたところ、どちらの欠陥も消えました。
直した箇所 | 前 | 後 |
|---|---|---|
緊急度の段階を排他的にする | 62.5% | 16件すべて正解 |
転送先の軸を1つに揃える(営業6件) | 16.7% | 6件すべて正解 |
公式ドキュメントは「1つの質問は1つの次元に保て」「段階は状況で書き、程度で書くな」と明記しています。2回とも、書いてあるとおりに直したら消えた欠陥でした。
ただし、Lunaは最初の雑なプロンプトのままでも営業電話を正しく分類していました。学習した知識で足りない部分を補うので、選択肢の説明が多少ずれていても答えが合います。Jevは書いたとおりにしか判定しません。軸が混ざっていれば、その混ざり方どおりに誤ります。
裏を返せば、プロンプトを詰める労力を払えば、Lunaと同じ精度を6分の1の時間と5分の1の費用で出せます。上位モデルへ替えられない以上、Jevで精度を上げる方法はプロンプトを直すことに限られます。
選定の分かれ目はそこです。判定の種類が少なくて長く使い回すなら、詰める労力は一度きりで済むのでJevが向きます。判定の種類が多くて頻繁に変わるなら、毎回詰め直すコストがLunaの価格差を上回ります。
私たちの次の作業は、この分類をAI電話の実運用に載せて、実際の受電で同じ精度が出るかを測ることです。今回の100件は自分で書いた台詞なので、そこが最後の確認になります。
関連記事


Grandream
株式会社グランドリーム
AI・システム開発のプロフェッショナルチームです。AIエージェント・業務自動化・Webシステム開発などを手がけています。